Domain saavedrabuch.de kaufen?
Wir ziehen mit dem Projekt
saavedrabuch.de um.
Sind Sie am Kauf der Domain
saavedrabuch.de interessiert?
domain@kv-gmbh.de · 0541-91531010
Domain saavedrabuch.de kaufen?
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **

Ähnliche Suchbegriffe für Portmann-Edy-Informationsextraktion-aus
Top-Angebote
Produkte zum Begriff Portmann-Edy-Informationsextraktion-aus:
-
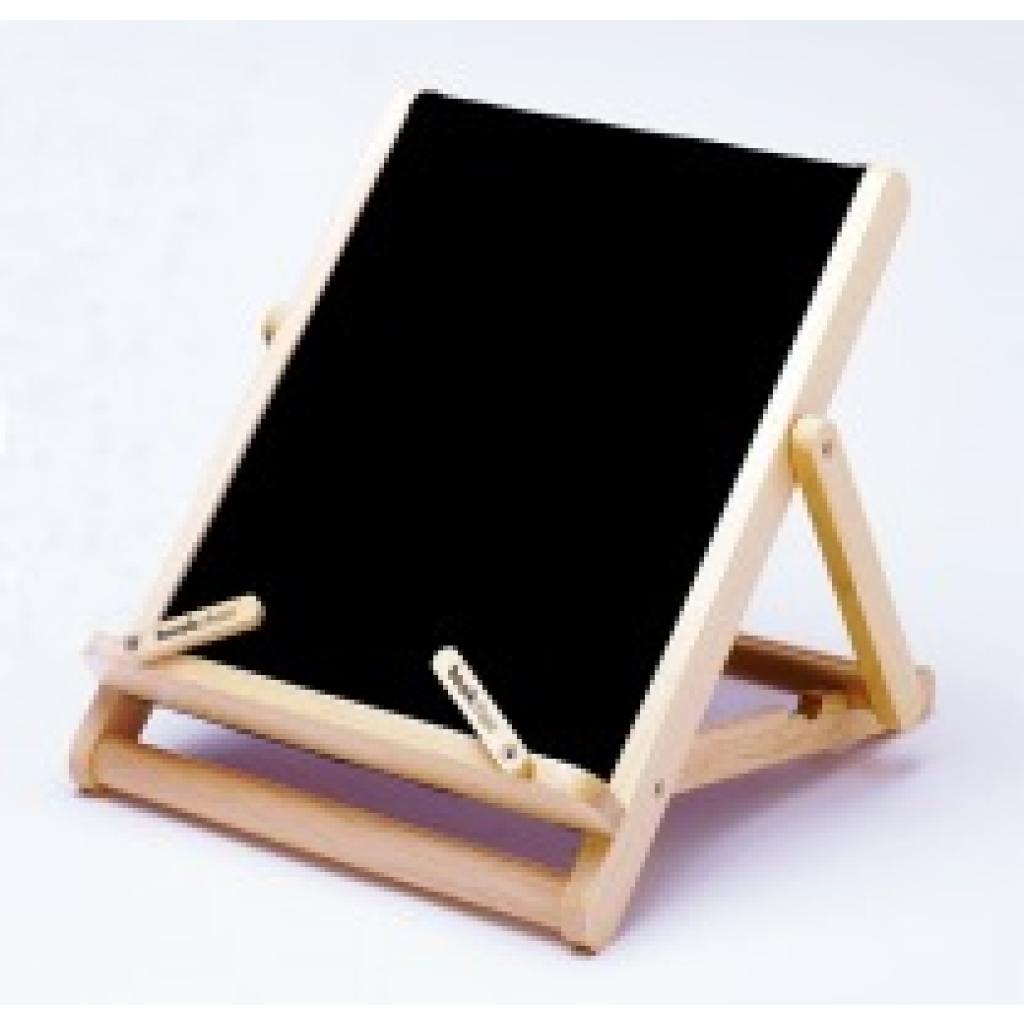
Bookchair (Standard) | Schwarz | Buchständer aus Holz | Leseständer | Für Bücher, E-Reader und Tablets | Lesehilfe | Tablethalter | freihändig Lesen | aktives Sitzen | ergonomisches Lesen | Geschenk für Leser & BuchliebhaberBookchair (Standard) | Schwarz | Buchständer aus Holz | Leseständer | Für Bücher, E-Reader und Tablets | Lesehilfe | Tablethalter | freihändig Lesen | aktives Sitzen | ergonomisches Lesen | Geschenk für Leser & Buchliebhaber , Durchdachter Lesekomfort Der Bookchair ist ein ergonomischer Leseständer für Bücher, E-Reader und Tablet-PCs. Ausziehbare Seitenhalter (bis 5 cm) halten auch dicke Bücher offen, so dass die Hände beim Lesen frei bleiben. Der Bookchair lässt sich auf drei Lesewinkel einstellen, praktische Gummistopper sorgen für rutschfesten Halt und zusammengeklappt passt der Bookchair in jede Tasche. Der ideale Buchständer für Studium, Freizeit und Reise. Mit dem STANDARD Bookchair sind sie auf der sicheren Seite. Dieser Buchständer ist auch für große Schulbücher, Kochbücher, Bildbände oder ihre DIN A4-Manuskripte geeignet. Auch Aktenordner oder Musiknoten finden darin Platz. Eine unentbehrliche Hilfe am Arbeitsplatz oder zu Hause! Neben seiner Funktion als Leseständer eignet sich der Standard Bookchair auch als Notebookhalter oder für Tablet-PCs. Holzständer mit Stoffbespannung Maße: 35 x 26 x 5 cm (Auflagefläche 27 x 23 x 3+2 cm) , Teichfilterzubehör > Teiche, Bachläufe & Brunnen , Erscheinungsjahr: 20200716, Keyword: Buchständer; Lesehilfe; Leseständer, Fachschema: Non Books / Buchständer, Warengruppe: NB/Sonstiges (Adreßbücher, Alben, Blankobooks), UNSPSC: 44209099, Warenverzeichnis für die Außenhandelsstatistik: 44209099, Sender’s product category: NONBO, Länge: 360, Breite: 288, Höhe: 24, Gewicht: 615, Produktform: NonBook, Genre: Importe,26,57 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter

-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **


Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
Top-Angebote
Produkte zum Begriff Portmann-Edy-Informationsextraktion-aus:
-
Bookchair (Standard) | Schwarz | Buchständer aus Holz | Leseständer | Für Bücher, E-Reader und Tablets | Lesehilfe | Tablethalter | freihändig Lesen | aktives Sitzen | ergonomisches Lesen | Geschenk für Leser & BuchliebhaberBookchair (Standard) | Schwarz | Buchständer aus Holz | Leseständer | Für Bücher, E-Reader und Tablets | Lesehilfe | Tablethalter | freihändig Lesen | aktives Sitzen | ergonomisches Lesen | Geschenk für Leser & Buchliebhaber , Durchdachter Lesekomfort Der Bookchair ist ein ergonomischer Leseständer für Bücher, E-Reader und Tablet-PCs. Ausziehbare Seitenhalter (bis 5 cm) halten auch dicke Bücher offen, so dass die Hände beim Lesen frei bleiben. Der Bookchair lässt sich auf drei Lesewinkel einstellen, praktische Gummistopper sorgen für rutschfesten Halt und zusammengeklappt passt der Bookchair in jede Tasche. Der ideale Buchständer für Studium, Freizeit und Reise. Mit dem STANDARD Bookchair sind sie auf der sicheren Seite. Dieser Buchständer ist auch für große Schulbücher, Kochbücher, Bildbände oder ihre DIN A4-Manuskripte geeignet. Auch Aktenordner oder Musiknoten finden darin Platz. Eine unentbehrliche Hilfe am Arbeitsplatz oder zu Hause! Neben seiner Funktion als Leseständer eignet sich der Standard Bookchair auch als Notebookhalter oder für Tablet-PCs. Holzständer mit Stoffbespannung Maße: 35 x 26 x 5 cm (Auflagefläche 27 x 23 x 3+2 cm) , Teichfilterzubehör > Teiche, Bachläufe & Brunnen , Erscheinungsjahr: 20200716, Keyword: Buchständer; Lesehilfe; Leseständer, Fachschema: Non Books / Buchständer, Warengruppe: NB/Sonstiges (Adreßbücher, Alben, Blankobooks), UNSPSC: 44209099, Warenverzeichnis für die Außenhandelsstatistik: 44209099, Sender’s product category: NONBO, Länge: 360, Breite: 288, Höhe: 24, Gewicht: 615, Produktform: NonBook, Genre: Importe,26,57 €*Versand: 0,00 €Sichere Weiterleitung zum Anbieter
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können verwendet werden, um Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die gängigen Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen durch statistische Analysen und Mustererkennung. Natural Language Processing ermöglicht die Verarbeitung von natürlicher Sprache, um relevante Informationen zu extrahieren. Machine Learning nutzt Algorithmen, um automatisch Muster in unstrukturierten Texten zu erkennen und Informationen zu extrahieren. **
-
Was sind die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen?
Die gängigsten Techniken zur Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und relevante Informationen zu extrahieren. **
-
Was sind die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die gängigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining analysiert große Mengen von Textdaten, um Muster und Trends zu identifizieren. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um automatisch Muster und Informationen aus den Daten zu extrahieren. **
Ähnliche Suchbegriffe für Portmann-Edy-Informationsextraktion-aus
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Daten sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Extraktion von relevanten Informationen aus großen Textmengen, während Natural Language Processing die Verarbeitung und Analyse von natürlicher Sprache ermöglicht. Machine Learning-Algorithmen können dabei helfen, Muster und Zusammenhänge in den Daten zu erkennen und automatisch Informationen zu extrahieren. **
-
Was sind die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Methoden zur Informationsextraktion aus unstrukturierten Texten sind Text Mining, Natural Language Processing (NLP) und Machine Learning. Text Mining beinhaltet das Extrahieren von Informationen aus großen Textmengen durch statistische und linguistische Analyse. NLP ermöglicht die Verarbeitung und Interpretation von natürlicher Sprache, während Machine Learning Algorithmen verwendet, um Muster und Zusammenhänge in den Texten zu erkennen. **
-
Was sind die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten?
Die wichtigsten Techniken zur Informationsextraktion aus unstrukturierten Texten sind Textklassifikation, Named Entity Recognition und Sentimentanalyse. Textklassifikation hilft dabei, relevante Informationen zu identifizieren, während Named Entity Recognition Namen, Orte und andere wichtige Entitäten extrahiert. Sentimentanalyse ermöglicht die Bewertung von Meinungen und Stimmungen in Texten. **
-
Was sind die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen?
Die Schlüsseltechniken für die Informationsextraktion aus unstrukturierten Datenquellen sind Text Mining, Natural Language Processing und Machine Learning. Text Mining ermöglicht die Identifizierung von relevanten Informationen in unstrukturierten Texten. Natural Language Processing hilft bei der Verarbeitung und Analyse von natürlicher Sprache. Machine Learning ermöglicht die Automatisierung von Extraktionsprozessen durch das Trainieren von Algorithmen auf vorhandenen Daten. **
* Alle Preise verstehen sich inklusive der gesetzlichen Mehrwertsteuer und ggf. zuzüglich Versandkosten. Die Angebotsinformationen basieren auf den Angaben des jeweiligen Shops und werden über automatisierte Prozesse aktualisiert. Eine Aktualisierung in Echtzeit findet nicht statt, so dass es im Einzelfall zu Abweichungen kommen kann. ** Hinweis: Teile dieses Inhalts wurden von KI erstellt.